数字化转型高分答卷 数据处理与存储支持服务“抄作业”指南
在数字经济浪潮下,数字化转型已不再是企业的“选择题”,而是关乎生存与发展的“必答题”。面对海量数据、复杂业务和快速变化的市场,如何交出一份高分答卷?答案就藏在“数据处理与存储支持服务”这一关键基石中。今天,我们就来拆解这份高分答卷,让你可以直接“抄作业”。
一、为什么数据处理与存储是转型的“命门”?
数字化转型的本质,是将数据转化为生产力。但现实是:数据孤岛林立、格式五花八门、查询慢如蜗牛、存储成本失控……没有扎实的数据处理和存储支持,任何AI、大数据分析都是空中楼阁。高分答卷的第一笔,就是构建统一、高效、安全的数据底座。
二、高分答卷的三大核心模块
1. 数据采集与集成:打破孤岛,应采尽采
- 多源接入:支持关系型数据库、NoSQL、API、日志文件、物联网设备等异构数据源。
- 实时+批量:兼顾实时流(如Kafka、Flink)与批量同步(如Sqoop、DataX),满足不同时效性需求。
- 数据清洗与标准化:在集成过程中完成去重、补全、格式转换,提升数据质量。
2. 数据处理与计算:让数据“活”起来
- 批流一体:采用Spark、Flink等引擎,统一处理离线与实时任务,降低运维复杂度。
- 湖仓一体:结合数据湖的灵活性与数据仓库的事务性,支持BI、AI、报表等多种场景。
- 弹性调度:基于云原生或K8s的动态资源分配,高峰不卡顿,闲时省成本。
3. 数据存储与服务:稳、快、省、安
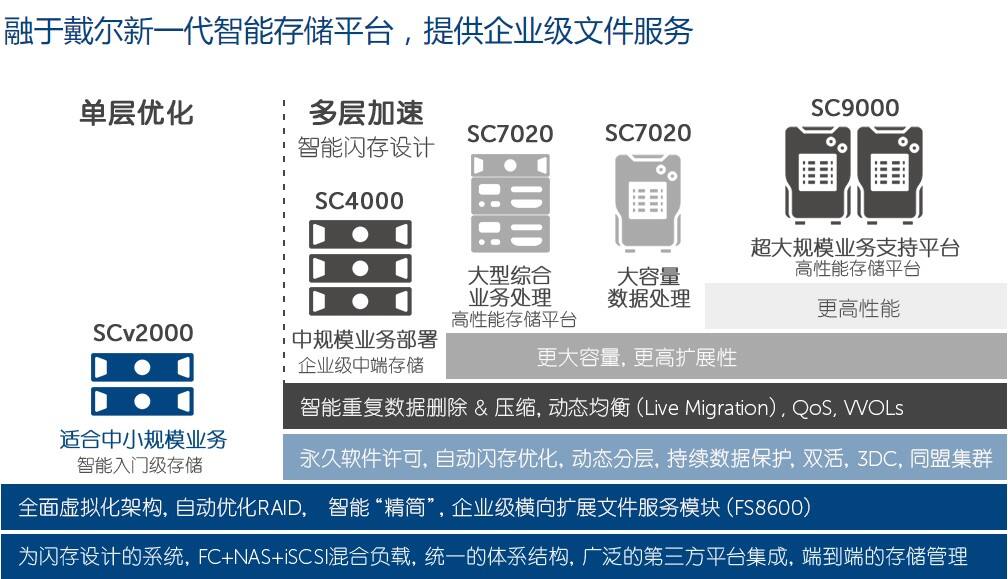
- 分层存储:热数据(SSD)、温数据(HDD)、冷数据(对象存储)自动分级,降低30%以上成本。
- 多模存储:行存、列存、KV、文档、图数据库按需选型,避免“一刀切”。
- 高可用与灾备:跨AZ/跨地域复制,RPO≈0,RTO<分钟级。
- 数据服务化:通过API网关、数据虚拟化,让业务系统像用水电一样调用数据。
三、可直接“抄作业”的架构参考
以某零售企业高分实践为例:
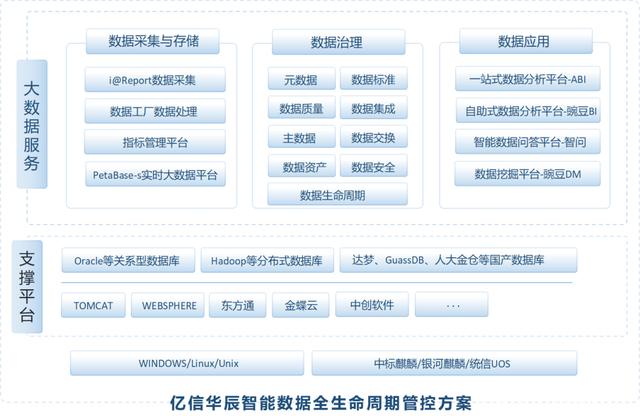
- 采集层:Canal同步MySQL增量,Filebeat收集日志,MQTT接入IoT。
- 处理层:Flink做实时风控与推荐,Spark离线跑T+1报表。
- 存储层:Hudi on S3做湖仓一体,Redis做热点缓存,ClickHouse做OLAP。
- 服务层:Data API平台统一输出,权限精细到行列级。
- 效果:查询性能提升12倍,存储成本下降45%,数据需求交付从2周缩短到2天。
四、“抄作业”的四个关键避坑点
- 别追求最新技术:适合业务现状的才是最好的。中小规模可从云托管服务(如阿里云DMS、AWS Glue)起步。
- 治理要同步:元数据管理、数据血缘、质量监控必须在上线前规划,否则越往后越痛。
- 安全合规是底线:加密(传输/静态)、脱敏、审计日志、GDPR/个保法遵从,缺一不可。
- 组织能力要跟上:设立数据产品经理、数据工程师、SRE等角色,避免“买来工具没人用”。
五、
数字化转型的高分答卷,没有唯一标准答案。但“数据处理与存储支持服务”一定是那张最关键的底卷。与其从零摸索,不如借鉴成熟架构与实战经验,结合自身业务做减法与适配。现在,这份“作业”已经摊开——你准备好动笔了吗?
如若转载,请注明出处:http://www.fotph.com/product/53.html
更新时间:2026-10-09 11:51:38